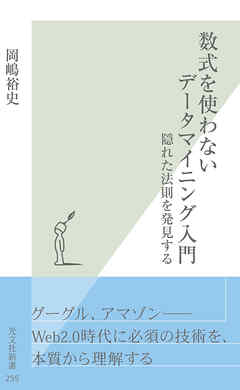
数式を使わないデータマイニング入門~隠れた法則を発見する~

数式を使わないデータマイニング入門~隠れた法則を発見する~

ビジネス・実用
770円 (税込)

3pt

インターネット上の玉石混淆の情報の中から「玉」を発見するには? グーグル、アマゾン――Web2.0時代に必須の知識・技術を本質から理解できる、世界一簡単な入門書。

詳しい情報を見る

閲覧環境

  • 【閲覧できる環境】
  • ・ブックライブ for Windows PC(アプリ)
  • ・ブックライブ for iOS(アプリ)
  • ・ブックライブ for Android(アプリ)
  • ・ブックライブ PLUS for Android(アプリ)
  • ・ブラウザビューア

※アプリの閲覧環境は最新バージョンのものです。

数式を使わないデータマイニング入門~隠れた法則を発見する~ のユーザーレビュー

\ レビュー投稿でポイントプレゼント / ※購入済みの作品が対象となります
レビューを書く

感情タグBEST3

    Posted by ブクログ

    データマイニングの手順と難しさを架空の例と共に分かりやすく解説している。
    統計手法のみの解説ではなく、データの収集や選択、見つけられる意味のない規則など、
    実際のデータマイニング時のイメージが浮かびやすい。
    どの事例もオリジナリティのある架空の例で、それでいて伝えたい内容が分かりやすい。
    よく考えられていると思った。

    0
    2009年10月07日

    Posted by ブクログ

    数式を使わないデータマイニング入門
    隠れた法則を発見する
    著:岡嶋 裕史
    紙版

    光文社新書 255

    統計分析は、情報が高コストであった時代に確立された学問体系です
    それは、できるだけ小さい情報量から、世界の姿を知ろうとする試みだと換言できます
    一方、現代は巷に情報があふらかえっています
    その差が指し示すのは、分析対象が深度を増すことであり、従来は分析対象にしなかった/できなかった情報も対象にできる
    すなわち、対象の幅が広がることでもあります

    本書は、社会システムの運用に欠かせない存在となったデータマイニングがどのようなものなのか、概要を説明する入門書です

    気になったのは以下です

    ・データマイニングは行為の総称であって、そこで行われる分析手法は複数存在し、分析目的によって選択される
     回帰分析
     決定木分析
     クラスタ分析
     ニューラルネットワーク

    ・データマイニングでは、圧倒的な情報量を用いて分析を行う

    ・従来型の統計分析の弱点の一つに、分析を思い立ってからデータを収集しはじめなければ、ならない点があった
     その過程で情報のスクリーニングが行われるし、そもそも情報収集に時間がかかり、タイムラグが発生してしまう

    ・すぐに役立つ情報でさえ保存できないのに、いつ役立つかもわからない情報を残しておく余裕はないのである
     しかし、社会の急速な情報化によって情報機器がくまなく普及し、情報の保存コストは幾何級数的に低下した
     一見無駄と思える情報を電子媒体上に取っておく余裕ができた

    ・こうして、企業をはじめ各組織体には、すぐに役立つか分からない情報、が蓄積されはじめた

    ・予測もしなかったデータ蓄積の増大は、分析家には朗報となった
     すなわち、自由に使える情報が飛躍的に増大し、しかも、それをリアルタイムで入手できるようになったのである

    ・情報量と演算能力は車の両輪であり、どちらが欠けても適切な情報の利用ができないが、現代はその両方を安価に入手できる時代である

    ・従来型の統計分析が、規定した法則の事後検証を指向しているのに対し、データマイニングは多分に未来予測指向である
     これも、利用できる情報の量と質が向上したことが大きい

    ・データマイニングにおけるマイニングは2段階のプロセスに分かれる
     ①大量の情報から隠れた法則を見つけ出すこと
     ②そこで見つかった法則のなかから、使えるものを探し出すこと

    ・さらに注意しておかなければならないのは、データマイニングはどんな局面にどのような法則が存在しているかを発見してくれはするものの、その原因を説明してはくれないことだ

    ・売れ筋商品と死に筋商品を峻別することで、不良在庫と欠品をなくす

    ・データウェアハウスの構築は、データマイニングの最初の一歩である

    ・ただ存在していればよいというものではない
     きちんと整理され、すぐに取り出せる状態に維持しておく必要がある

    ・チラシをまく場所を変更したり、駐車場を拡充して顧客の定着をはかるなどの手段を講じることができる

    ・データの集め方
     ①行いたいデータマイニング用に、データを収集する
     ②現状で持っているデータを、データマイニング用に転用する

    ・そもそも、データ南下取っていない、という組織や人はとっても多いのである

    ・一般的にデータマイニングを行う場合、いかに多くのデータを取り込むかに意識が傾注される
     それももちろん正しいのだが、どこで見切りをつけるのかも、同様に重要であることを理解しておきたい

    ・何が必要で何が不要なのかは、データマイニングを行う際の永遠のテーマである

    ・データマイニングは、おびただしい情報のなかから規則や法則を見つけ出してくれるが、そのほとんどは、役に立たない法則か、意味のない法則だと考えておいた方がよい

    ・各分析手法の得意な局面は、おおむね次のとおりである
     分類 クラスタ分析、決定木分析、自己組織化マップ
     関連発見 連関規則
     予測 回帰分析、ニューラルネットワーク

    ・決定木を育てすぎると過学習になる
     育ちすぎた決定木は、情報に過敏に反応してしまい、かえって正確な予測ができなくなってしまうことがある

    ・分けることは分かること

    ・先生が教えてくれるのが、教師あり分類
     自分で考えるのが、教師なし分類

    ・クラスタ分析:あるデータのなかから、意味ありげなまとまりを見つけ出し、グループ化すること

    ・連関規則 Aが起こると、Bが発生する
     Aの方を、ルールヘッド
     Bの方を、ルールボディ と呼ぶ

    ・OECDプライバシガイドラインは、次の8原則から構成されている
     ①収集制限の原則
     ②データ内容の原則
     ③目的明確化の原則
     ④利用制限の原則
     ⑤安全保護の原則
     ⑥公開の原則
     ⑦個人参加の原則
     ⑧責任の原則

    ・情報を保有することが資産ではなく、リスクになってしまった

    目次
    まえがき
    第1章 隠れた法則を見つける技法
    第2章 ビジネスで使われるデータマイニング
    第3章 データマイニングの手順
    第4章 落としどころを探る―回帰分析
    第5章 効率的に判断する―決定木
    第6章 分けることは分かること―クラスタ分析
    第7章 複雑な分類―自己組織化マップ
    第8章 買い物かごの中身は?―連関規則
    第9章 神経をまねしてみる―ニューラルネット
    第10章 データマイニングと情報管理
    第11章 監視社会とデータマイニング
    参考文献

    ISBN:9784334033552
    出版社:光文社
    判型:新書
    ページ数:216ページ
    定価:700円(本体)
    発売日:2006年05月20日初版第1刷

    0
    2024年05月10日

    Posted by ブクログ

    情報の使い方、分析屋のあり方をメインにインプットしようと思って読んだ。データマイニングにおける「考える」手順が丁寧に書かれている。当たり前と言われればそれまでかもしれないが、基本に忠実にあるべきだと感じた。数字に追われているようではいけない。

    0
    2013年05月05日

    Posted by ブクログ

    タイトル通りに平易な数学の知識で読める本。データマイニングとは究極的にいえば分類して、知識を整理・発見することだと思う。それをいろいろなツールで行うことに過ぎない。そのツールを紹介し、現代っ子にも解りやすい例示を使っているのもよい。

    IT業界はビックデータブームだが、その入門にもいい本。

    0
    2012年01月12日

    Posted by ブクログ

    データまイニングについて、文字通りほとんど数式を使わずに記述した入門書。
    豊富なたとえ話を交え、わかりやすいのが最大の特徴。

    一番参考になったのは、「データマイニングは、データを分析してくれるけど、答を出すのは人間」という点。
    えてして万能なものと過信しがちなので、その1点だけでこの本を読んだ価値があった。

    あと、最後のビッグブラザーの話は漠然とわかっていても、改めて言われると戦慄が走る内容。

    0
    2011年11月21日

    Posted by ブクログ

    題名の通りに本格的な数式は登場せず、厳密さを犠牲にしても分かりやすさにこだわってデータマイニングの何たるかを豊富な例により説明しています。データマイニングとは何か、データマイニングで何ができるかを大雑把に理解するにはコンパクトでとても分かりやすいのですが、引用されている例がいずれもオタク好みの例なので、人によって好みが分かれるかもしれません。その点を差し引いてもデータマイニングをお手軽に知っておきたい人には最初に読む一冊としてよいと思います。

    0
    2011年11月11日

    Posted by ブクログ

    データマイニングの考え方を易しく説いた良書。数式を使わないと謳うだけあって、本当にさわりのさわり程度の内容です。しかし初心者がいきなり数式満載の入門書に取りつくのは極めて危険です。「データマイニング?それって食べられるの?」レベルな方は本書を読んで雰囲気を感じるだけでも有益だと思われます。

    0
    2011年09月27日

    Posted by ブクログ

    データマイニング⇒情報管理⇒監視を分かりやすく。
    回帰分析(落としどころを探る)。
    決定木(効率的に判断する)クラスタ分析(分からないことは分かること)。
    自己組織化マップ(複雑な分類)連関法則(買い物かごの中身は?)ニューラルネット(神経をまねしてみる)
    自己組織化マップ=コホーネント

    0
    2012年07月21日

    Posted by ブクログ

    データマイニングの導入本。数式などは一切使わず、ただひたすら定性理解に努めている。

    データマイニングについてよく知らない人にはもちろん、何となく使っているだけ程度の人も読んだら気づかされることがあるかも。
    構成は、始めにデータマイニングの概観、次に代表的な手法の定性的な解説、最後にデータマイニングの弊害について、といった感じ。

    この本の良いところは
    ・出てくる例えにユーモアがあって読んでて飽きない
    ・良いところだけでなく、弊害についても触れている
    ところだと思う。

    少し古いけど、まだまだ読まれて然るべき本だと思った。
    ・

    0
    2011年04月02日

    Posted by ブクログ

    2006年の新書だけど、今でも全然いける内容。
    新書の多くはそのときの新鮮なネタで年をまたぐと輝きを失うものが多いが、本書は違った。

    これからの時代、もっと輝く、昆布的な存在感の本となるだろう。
    以下、目次。

    第1章 隠れた法則を見つける技法
    第2章 ビジネスで使われるデータマイニング
    第3章 データマイニングの手順
    第4章 落としどころを探る―回帰分析
    第5章 効率的に判断する―決定木
    第6章 分けることは分かること―クラスタ分析
    第7章 複雑な分類―自己組織化マップ
    第8章 買い物かごの中身は?―連関規則
    第9章 神経をまねしてみる―ニューラルネット
    第10章 データマイニングと情報管理
    第11章 監視社会とデータマイニング

    0
    2010年12月16日

数式を使わないデータマイニング入門~隠れた法則を発見する~ の詳細情報

閲覧環境

  • 【閲覧できる環境】
  • ・ブックライブ for Windows PC(アプリ)
  • ・ブックライブ for iOS(アプリ)
  • ・ブックライブ for Android(アプリ)
  • ・ブックライブ PLUS for Android(アプリ)
  • ・ブラウザビューア

※アプリの閲覧環境は最新バージョンのものです。

この本をチェックした人は、こんな本もチェックしています

光文社新書 の最新刊

無料で読める IT・コンピュータ

IT・コンピュータ ランキング

岡嶋裕史 のこれもおすすめ

同じジャンルの本を探す